Copilot Studio, Agent Factory · 28 ott 2026 · 17 min di lettura
Copilot Agent Factory: come stimare la complessità di un agente
Copilot Agent Factory: come dimensionare gli agenti Copilot Studio con le taglie S/M/L/XL, scegliere l’harness e governare rilascio e rischio.
- #copilot-studio
- #microsoft
- #agenti-ai
- #alm
- #sviluppo
Lo scenario: tre agenti, tre errori di architettura travestiti da errori di stima
Immaginate una riunione di avvio progetto. Il cliente chiede un agente in Copilot Studio che risponda alle domande dei dipendenti sulla policy ferie. Un use case, una fonte su SharePoint, un gruppo di utenti. Il team lo stima in due settimane, lo consegna in tre, tutti contenti.
Qualche mese dopo arriva una seconda richiesta: "Vogliamo lo stesso tipo di agente, ma per la riconciliazione delle fatture fornitori". Anche qui, sulla carta, un solo use case. Ma dentro quel singolo use case ci sono un MCP server custom verso il gestionale, approvazioni umane prima di ogni scrittura, controlli contabili, gestione degli errori quando il sistema a valle non risponde. Il team lo stima come il primo, perché "è un use case solo". Tre mesi dopo il progetto è ancora aperto, il budget è finito e nessuno sa dire con certezza se l'agente sia pronto per la produzione.
E poi c'è il terzo caso, il più insidioso: un agente nato piccolo che cresce per accumulo. Prima le FAQ, poi un connettore verso Dataverse, poi un flow Power Automate che scrive dati, poi un secondo agente collegato. Nessuno ha mai deciso che quel progetto fosse diventato "grande", quindi nessuno ha mai aggiunto i test, le approvazioni e il monitoraggio che un agente grande richiede. Finché un giorno l'agente scrive un dato sbagliato su un record importante e la domanda che arriva è: chi aveva approvato questa cosa?
Chi fa il mio mestiere riconosce subito il pattern. Questi non sono errori di stima: sono decisioni architetturali mai prese, e quindi prese implicitamente dal primo che ha aperto l'editor. Nel secondo caso nessuno ha disegnato il trust boundary fra l'agente e il gestionale. Nel terzo nessuno ha riclassificato il sistema quando la sua topologia è cambiata. In entrambi i casi la complessità era lì, visibile a chi sapeva guardare, ma non esisteva un linguaggio per nominarla e un momento per fermarsi a deciderla.
Nel mondo degli agenti AI il numero degli use case è una metrica di superficie: dice quante porte ha la casa, non quanto è solido il fondamento. Le dimensioni che contano davvero per un architetto sono altre: quanti sistemi tocca l'agente, con quali privilegi, quanto è autonomo nel decidere il prossimo passo, cosa succede se sbaglia e chi se ne accorge.
Da qui nasce la proposta di una Agent Factory: uno standard interno, sottoposto all'AI Centre of Excellence, che trasformi queste dimensioni in decisioni esplicite, documentate e approvate. Lo dico subito per onestà verso chi legge: le cinque fasi del ciclo di vita e la distinzione fra i due harness arrivano dalla documentazione Microsoft; le taglie, le soglie numeriche e i gate che descrivo sono scelte nostre, e le funzionalità in anteprima vanno rivalidate prima di finire in produzione.
Il ciclo di vita come sequenza di decisioni, non di attività
La prima cosa che l'Agent Factory fissa è che tutti gli agenti, piccoli o grandi, seguono le stesse cinque fasi dell'Agent Development Lifecycle (ADLC) definito da Microsoft. Ma la lettura che ne do è diversa da quella di un project manager: ogni fase è il punto in cui una certa classe di decisioni diventa costosa da cambiare, e il gate è il momento in cui quelle decisioni vengono congelate consapevolmente.
| Fase | Decisione architetturale che si congela | Gate di uscita |
|---|---|---|
| Discovery | Perimetro, attori, dati toccati, modello di rischio iniziale, taglia e harness provvisori | G1 — Scope & architecture approval |
| Experimentation | Fattibilità misurata: harness confermato su evidenze, baseline di qualità e costo, taglia definitiva | G2 — Feasibility / Go-No-Go |
| Build | Topologia, integrazioni, modello autorizzativo, strategia di error handling | G3 — Build quality gate |
| Deploy | Pacchetto, ambienti, rollback, responsabilità operative | G4 — Production go-live |
| Operational Steady State | Drift, costi, evoluzione dello scope e necessità di riclassificazione | G5 — Service review ricorrente |
Nessuna taglia è esonerata dai gate. Cambia la profondità delle evidenze richieste, non l'esistenza del controllo. Un agente S passa da G4 con un UAT compatto e un rollback descritto in mezza pagina; un XL ci passa con security review, resilience test e un rollback esercitato davvero. La differenza è proporzionale al rischio, non alla voglia di fare burocrazia.
Il terzo scenario si risolve qui: l'agente cresciuto per accumulo avrebbe incontrato G5 e, al primo cambio di topologia, sarebbe tornato in Discovery con una taglia nuova e i controlli corrispondenti.
La taglia è un modello di rischio, non un listino
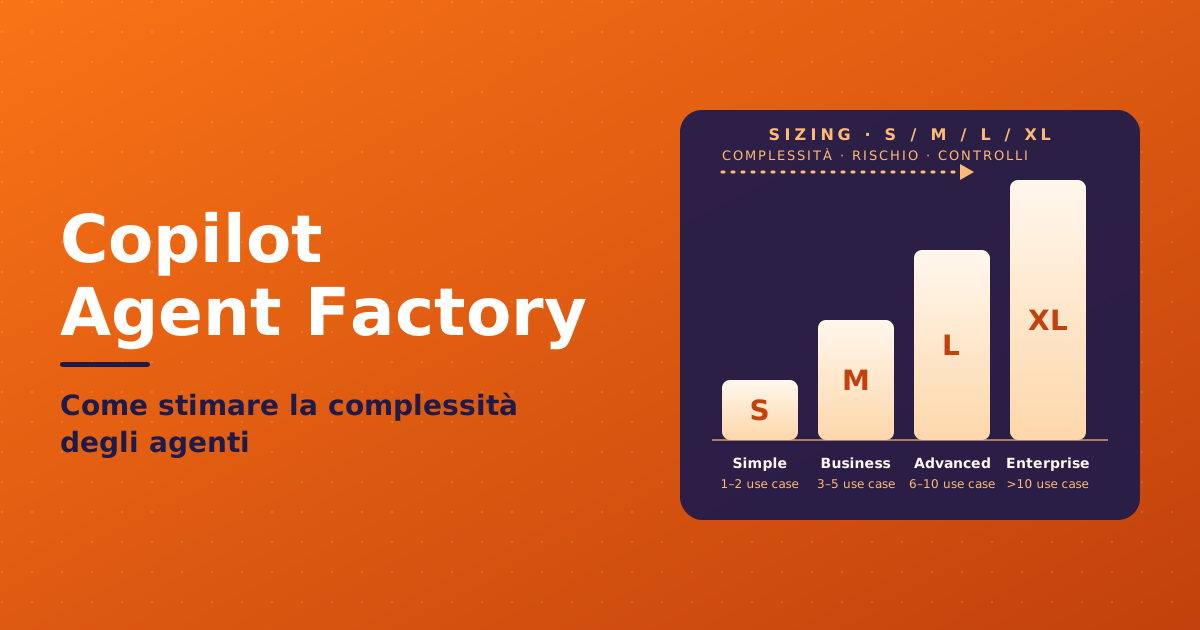
Abbiamo scelto quattro taglie, S/M/L/XL, perché sono facili da discutere con il business. Ma vorrei che fosse chiaro cosa rappresentano per chi progetta: la size è una sintesi del rischio architetturale complessivo del delivery, non il numero degli use case e non il prezzo.
In breve: S — Simple Agent è l'agente delle policy ferie, singolo e low-code, con un trust boundary banale. M — Business Agent è un singolo agente avanzato che scrive dati con controlli: è la prima taglia in cui il modello autorizzativo diventa un tema di design e in cui si decide formalmente l'harness. L — Advanced Agent introduce integrazioni enterprise, approvazioni umane, compensazioni e una regression suite automatizzata: la topologia può diventare multi-agente. XL — Enterprise Agent System è un sistema distribuito di agenti cross-domain, con audit trail, policy di esecuzione e human-in-the-loop progettati come componenti, non come eccezioni.
La matrice che segue è il cuore dello standard. Le righe sono le taglie, le colonne le cinque fasi. I numeri di use case e scenari di test sono soglie di policy proposte, non limiti di prodotto.
| Size | 1. Discovery | 2. Experimentation | 3. Build | 4. Deploy | 5. Operational Steady State |
|---|---|---|---|---|---|
| S — Simple Agent | 1–2 use case, stesso processo; un gruppo di utenti; un dominio informativo; KPI e criteri di accettazione essenziali; fonti e strumenti standard; Standard Harness presuntivo, salvo requisito specifico contrario. | PoC breve con flussi prevalentemente lineari; 10–20 scenari positivi e negativi; qualità risposta, grounding, errori comuni e permessi base; prima verifica di consumo e latenza. | Un agente Standard Harness, topic e istruzioni semplici; fonti di conoscenza e fino a 2–3 tool standard (limite di sizing, non di prodotto); nessun MCP custom o agente collegato; prevalentemente low-code. | Solution; percorso DEV → TEST → PROD proporzionato; verifica identità e autorizzazioni; UAT compatto; un canale prioritario; release e rollback documentati. | Analytics nativi; monitoraggio di disponibilità, errori, utilizzo, qualità/feedback e crediti; revisione periodica manuale e piccole correzioni. |
| M — Business Agent | 3–5 use case su 1–2 processi; diversi stakeholder; mappa di permessi, dati, dipendenze e KPI; decisione formale Standard vs GitHub Copilot Harness quando servono autonomia e reasoning. | PoC multi-step con tool calling, eccezioni e contesto conversazionale; 30–50 scenari; grounding, multi-turn, casi negativi, profili autorizzativi; confronto fra harness se incerto, con costo e latenza. | Singolo agente avanzato: Standard Harness con orchestrazione esplicita, oppure GitHub Copilot Harness per autonomia circoscritta; Dataverse, connettori, Power Automate, MCP standard dove utile; skills solo se supportate e necessarie; logica prevalentemente low-code. | Managed Solution, environment variables e connection references; pipeline Power Platform; regression test e UAT formale; controllo ruoli e supporto ai canali del runtime scelto. | Dashboard con KPI di business, errori, prestazioni, crediti e attività; revisione di esecuzioni e strumenti; backlog e cicli periodici di aggiornamento. |
| L — Advanced Agent | 6–10 use case o complessità equivalente; più processi collegati; solution architecture e integrazioni enterprise; esame di MCP, API, approvazioni e NFR; decisione motivata su agentic loops, memoria, skills e agenti collegati; security assessment. | PoC end-to-end; 75–150 scenari con test di tool selection, autorizzazioni, prompt injection, exception recovery, multi-turn e integrazioni; misure di qualità, latenza, costo e comportamento in errore. | GitHub Copilot Harness se servono reasoning e adattamento, altrimenti Standard Harness per processi controllati; possibili agenti specializzati; MCP standard, API custom, connettori custom o Azure Functions; skills e memoria quando giustificate; approvazioni umane, logging e compensazioni. | CI/CD via Power Platform Pipelines, GitHub Actions o Azure DevOps; quality gate automatici, test di integrazione, sicurezza, UAT multi-ruolo; piano di rollback verificabile. | Telemetria di workflow e tool, cost allocation per scenario, metriche di affidabilità, anomaly review; regression suite automatizzata; incident e change management; evaluation periodica. |
| XL — Enterprise Agent System | >10 use case o complessità equivalente; processi cross-domain e più team; discovery multi-workstream; topologia di agenti e sistemi; threat modeling, compliance, audit, resilienza, responsabilità e policy di autonomia; harness scelto per ciascun componente. | PoC multi-agent e multi-tool, percorsi alternativi e recovery; >150 scenari inclusi stress, adversarial, approvazioni, failure injection, governance dei dati, memoria, parallelismo e benchmark end-to-end su qualità, latenza e consumi. | GitHub Copilot Harness per orchestratori reasoning-intensive, con Standard Harness per componenti deterministiche; più agenti e agenti collegati, skills riutilizzabili, memoria persistente quando utile, MCP custom, API enterprise, document/file processing, audit trail, policy di esecuzione e human-in-the-loop. | Release multi-ambiente con dipendenze versionate; pipeline automatizzate e separazione dei ruoli; security e architecture review, evaluation gate, UAT cross-domain, resilience test, distribuzione progressiva ove supportata, rollback esercitato. | Osservabilità end-to-end per agente, tool e workflow; SLO, incident response e audit continuo; tracciamento consumi per processo; governance di versioni e dipendenze; evaluation continua e miglioramento coordinato. |
Notate quel "o complessità equivalente" nelle taglie L e XL. È lì che vive il secondo scenario: la riconciliazione fatture ha un solo use case ma, per topologia, integrazioni, azioni sui dati e necessità di recovery, è un L se non un XL. Non è un S per il solo fatto di avere un use case.
Le dodici dimensioni e il criterio prudenziale
Per non lasciare la classificazione al gusto personale, la taglia si assegna valutando dodici dimensioni, che sono di fatto le viste architetturali che un Solution Architect compila comunque: use case, processi e dominio, stakeholder, topologia degli agenti, orchestrazione, reasoning e contesto, harness, integrazioni, skills e memoria persistente, azioni sui dati, evaluation, ALM e operations. Per ognuna si attribuisce una classe S, M, L o XL in base ai valori reali del progetto.
Poi vale il criterio prudenziale: la taglia preliminare è il livello più alto rilevato, con l'obbligo di motivare quale dimensione lo ha determinato. Se quel driver isolato non incide davvero su effort o rischio, si può chiedere una deroga motivata all'AI Architect, ma la taglia non si abbassa automaticamente. E si riesamina al gate G2, dopo il PoC, e ogni volta che cambiano scope, runtime, integrazioni, volumi o grado di autonomia.
Qualche esempio per fissare l'idea:
- Due use case, FAQ su SharePoint e una richiesta standard via connettore → S.
- Quattro use case con Dataverse, tool standard e flussi condizionali → M.
- Un use case di riconciliazione finanziaria con MCP custom, approvazioni e recovery articolato → L/XL da valutare.
- Un processo di audit multidominio con più agenti, grandi documenti e memoria persistente → XL.
Una regola di igiene professionale, scritta nero su bianco: non si introduce un requisito tecnico solo per alzare la taglia commerciale di un progetto. La taglia protegge il delivery; se la usiamo per gonfiare il preventivo, perde ogni credibilità al primo audit.
L'harness è una decisione di runtime, ed è irreversibile
Qui sta il punto che genera più confusione, e che per un architetto è la decisione più pesante dell'intero ciclo.
Copilot Studio offre due runtime, che Microsoft chiama harness. Lo Standard Harness è il modello che conosciamo: topic, variabili, strumenti, flussi disegnati esplicitamente; l'orchestrazione è progettata, non emergente. Il GitHub Copilot Harness è un runtime pensato per lavori prolungati e multi-step, con planning dinamico, agentic loop, contesto ampio condiviso fra subagenti, elaborazione avanzata di file Word, Excel, PowerPoint e PDF, skills e memoria persistente.
Due precisazioni, perché il nome inganna anche i tecnici. Primo: GitHub Copilot Harness non è GitHub Copilot per sviluppatori e non è GitHub Actions; è un framework di authoring e orchestrazione dentro Copilot Studio. Usare GitHub come repository o per la CI/CD è una decisione di ALM del tutto indipendente dal runtime. Secondo: la scelta dell'harness è separata dal sizing. Un XL non è obbligatoriamente GitHub Copilot Harness; un S potrebbe in teoria usarlo se una capacità esclusiva è indispensabile, pagando una rivalutazione di rischio ed effort. E né un MCP, né un agente collegato, né un connettore Dataverse implicano da soli il runtime più complesso.
Il modo in cui ragiono è questo:
- Standard Harness quando il risultato deve essere prevedibile, il processo è delimitato, la risposta va controllata parola per parola e non serve pianificazione autonoma prolungata. È la scelta di default: la soluzione più semplice che soddisfa i requisiti.
- GitHub Copilot Harness quando l'obiettivo richiede planning e replanning dinamico, contesto ampio, file complessi, cicli di refinement, subagenti con contesto condiviso, memoria o skills. Non "perché è nuovo", ma perché un requisito specifico non è soddisfabile altrimenti.
- Ibrido quando il front-end conversazionale deve seguire percorsi controllati mentre un'altra componente esegue elaborazioni lunghe e autonome. Qui la responsabilità dell'architetto è separare nettamente i ruoli dei componenti e verificare che i meccanismi di collegamento siano davvero supportati, non ipotizzati.
Il vincolo che rende tutto questo serio: gli agenti non si convertono da un harness all'altro. Cambiare runtime è una re-architecture, con una nuova valutazione dei journey essenziali. È il motivo per cui la decisione si prende in Discovery, si verifica in Experimentation con un PoC comparativo quando c'è incertezza, e si congela a G2. Dopo, costa.
Incide anche il modello economico, che un architetto deve mettere nel decision record: lo Standard Harness segue le licenze Copilot Studio, il GitHub Copilot Harness consuma Copilot Credits legati all'uso, e il consumo va stimato anche per build, test ed evaluation, non solo per la produzione.
Il Decision Record
Dalla taglia M in su l'harness va documentato in un Architecture Decision Record con un contenuto minimo: scenario, requisiti di autonomia e durata, integrazioni e volumi, security model, canali, requisiti documentali, harness candidati, vincoli di disponibilità, costi di build/test/run, benchmark del PoC, scelta, motivazione e approvatore. È il documento che, sei mesi dopo, risponde alla domanda "perché avete fatto così?" senza bisogno di ricordarselo.
Il trust boundary: dove vivono davvero le autorizzazioni
Un agente che scrive dati ha un trust boundary da disegnare, e la regola che l'Agent Factory rende vincolante è che l'autorizzazione si verifica nel sistema di destinazione, non nelle istruzioni dell'agente. Un prompt che dice "non modificare record di clienti strategici" non è un controllo di sicurezza: è un'intenzione. Il controllo è il ruolo Dataverse, il permesso sull'API, la policy DLP, l'identità Entra ID con least privilege.
Da questo discendono alcune scelte che vanno disegnate prima del Build: human approval prima di azioni irreversibili, ad alto impatto economico o che toccano dati sensibili; logging e auditabilità delle operazioni; compensazioni per quando il passo successivo fallisce; adversarial testing, prompt injection e data exfiltration test per ogni integrazione che espone dati o strumenti. Nella matrice vedete queste voci comparire con intensità crescente da M in su: non è un caso, è il trust boundary che si allarga.
Evaluation come criteri di accettazione, non come collaudo
Il principio che più vorrei restasse è che agenti e modifiche sono evaluation-driven. Un agente non si "prova un po'" prima del rilascio: si misura contro un set di scenari costruito apposta, e si rimisura ogni volta che cambiano istruzioni, modello, topic, strumenti, MCP, knowledge source, permessi o orchestrazione. Nel vocabolario dell'architettura, l'evaluation set è il modo in cui i requisiti non funzionali diventano verificabili.
Le soglie di scenari nella colonna Experimentation (dai 10–20 di un S agli oltre 150 di un XL) sono minimi di pianificazione, da alzare in base a criticità e volumi: non garantiscono copertura. Tre accorgimenti progettuali:
- Per le azioni critiche la soglia di accettazione è più rigorosa della semplice qualità conversazionale, con acceptance criteria specifici e blocchi al rilascio.
- Si testa la tool selection: che l'agente scelga lo strumento giusto con i parametri giusti è un requisito, non un dettaglio.
- Quality, latency e Copilot Credits si misurano per workflow completato, non per singola chiamata, perché è il workflow quello che il business paga e di cui si fida.
ALM: meccanismi, non architettura
Sul fronte ALM la baseline è nota a chi lavora su Power Platform, ma va ribadita perché negli agenti si tende a saltarla. Ambienti DEV, TEST/UAT e PROD separati almeno logicamente; Power Platform Solutions con environment variables e connection references; unmanaged in DEV, managed nei target; pipeline riproducibili con rollback e gestione delle dipendenze; verifica delle componenti e dei canali che richiedono impostazioni post-deployment.
Lo ripeto perché è l'equivoco più frequente nelle riunioni: Power Platform Pipelines, GitHub Actions e Azure DevOps sono meccanismi ALM. Non sono harness, non determinano la taglia e non influenzano la scelta del runtime.
Accountability: ogni decisione ha un nome accanto
Un modello così funziona solo se le responsabilità sono esplicite. Il Business Owner risponde di valore, KPI e UAT; l'AI Architect di sizing e harness selection; il Tech Lead di build e integrazioni; il QA / AI Evaluation Lead dell'evaluation; il Security / Compliance Owner di policy, sicurezza e privacy; il Platform / Release Owner di release e change management; l'Agent Owner con le Operations dell'esercizio e degli incidenti.
Ogni gate ha i suoi approvatori: G1 Product Owner e AI Architect; G2 AI Architect e Business Owner; G3 Tech Lead con QA e Security; G4 Business Owner, Operations e Security secondo il rischio; G5 Agent Owner e Operations. Torniamo al terzo scenario: alla domanda chi aveva approvato questa cosa? la risposta esiste ed è scritta nel verbale di G4.
Prima del go-live: la checklist
Chiudo con la checklist di production readiness, che è lo strumento più pratico dell'intero standard. Prima di G4 devono essere veri tutti questi punti:
- Use case, KPI, utenti e owner approvati.
- Taglia motivata e confermata dopo l'Experimentation.
- Harness decision record approvato (o motivazione semplificata per S).
- Architettura, data flow e inventario di strumenti e MCP documentati.
- Identità, permessi, DLP, privacy e responsabilità sulle azioni validati.
- Copertura di evaluation proporzionata al rischio, regressioni superate.
- Gestione di errori, timeout, retry ed escalation documentata.
- Ambienti e pacchetto di release verificati, configurazioni e segreti gestiti.
- UAT e security gate completati.
- Osservabilità, dashboard, incident owner e budget crediti configurati.
- Piano di rollback o modalità sicura di disabilitazione verificato.
- Approvazione G4 formalmente registrata.
In conclusione
Gli agenti AI sono diventati sistemi distribuiti a tutti gli effetti: hanno integrazioni, trust boundary, stato, costi ricorrenti e un comportamento che non è interamente deterministico. Trattarli come esperimenti da due settimane funziona finché restano esperimenti; smette di funzionare nel momento in cui qualcuno ci mette sopra un processo di business.
L'Agent Factory non è un freno all'innovazione. È il modo per far sì che le decisioni architetturali vengano prese quando costano poco, da chi ha la responsabilità di prenderle, con un record che le motiva. Il primo agente, quello semplice, resta semplice davvero; il secondo e il terzo arrivano in produzione con i controlli che la loro complessità reale richiede. Un linguaggio comune per dire quanto è grande un agente è, alla fine, un linguaggio comune per dire quanto possiamo fidarci.
Lo standard è una proposta in versione 1.0, in attesa di approvazione dell'AI CoE, e verrà rivisto a ogni variazione sostanziale di piattaforma, harness, licensing o funzionalità preview.
Fonti Microsoft di riferimento: Agent development lifecycle, Harnesses in Copilot Studio, Compare Copilot Studio agent harnesses, Agents powered by the GitHub Copilot Harness, Copilot Studio guidance, ALM guidance. Le fonti supportano i principi tecnologici citati, non le soglie interne di sizing.